
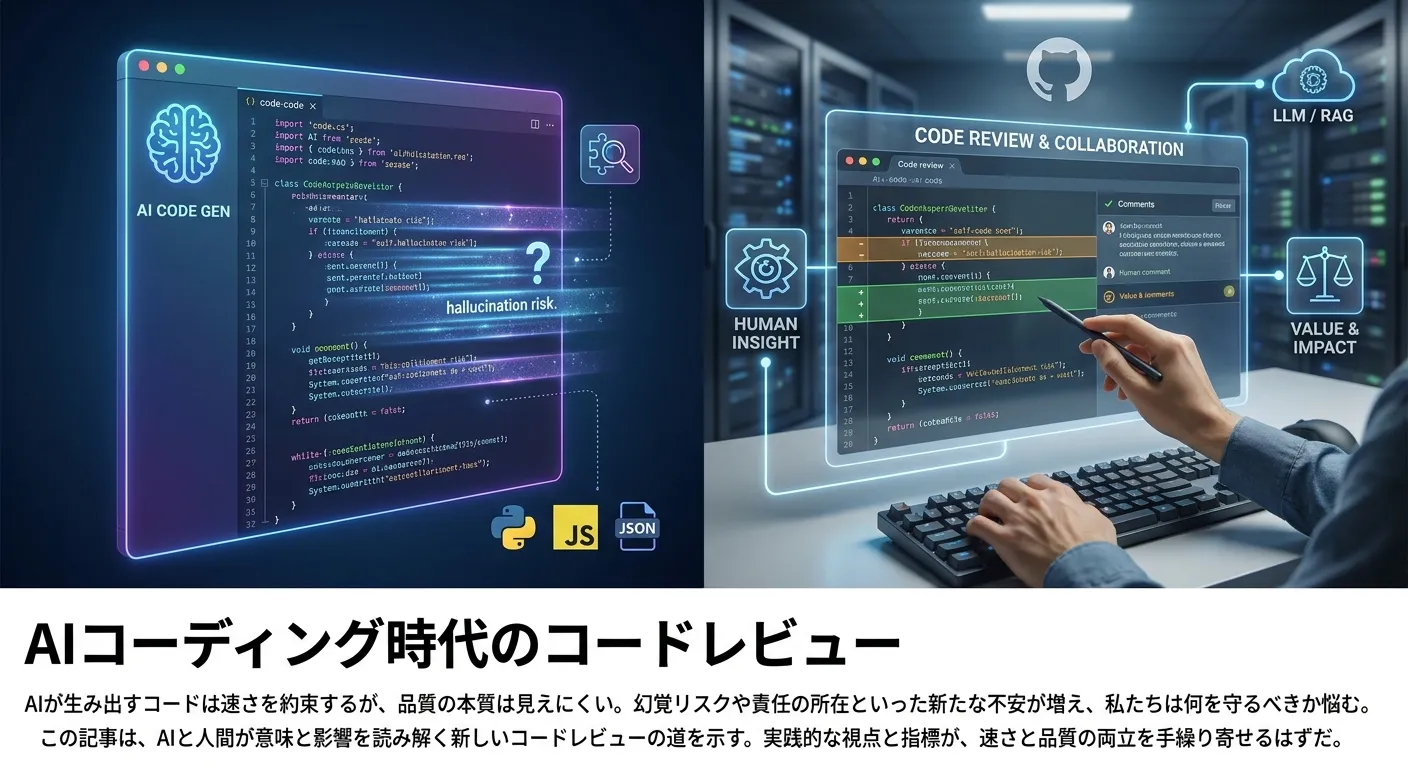
AIが生み出すコードは速さを約束するが、品質の本質は見えにくい。幻覚リスクや責任の所在といった新たな不安が増え、私たちは何を守るべきか悩む。この記事は、AIと人間が意味と影響を読み解く新しいコードレビューの道を示す。実践的な視点と指標が、速さと品質の両立を手繰り寄せるはずだ。読後には、組織を変える教育と文化のヒントも手に入る。
この記事の答え
- 結論AIコーディング時代のコードレビューは、人が意味と影響を判断して品質と速さを両立する。
- 根拠RAGで根拠を照合し、注釈と出力追跡を残して幻覚を抑え、最終責任を人が担う。
- 最初の一歩まず要件を明文化し、生成後にRAG照合と人のrubric評価を行うレビューを試す。
第1章:AI時代のコードレビューと私の葛藤
第1章:AI時代のコードレビューと私の葛藤 - 本文
夕暮れのオフィス。翔太は画面に並ぶコードの列をじっと見つめ、深いため息を漏らした。社内では生成AIによるコード修正が広まり、確かに作業は速くなった。社内調査では86%のチームが生成AIを試し、レビューのスピードは一時的に3.8倍になった。しかし、速さの裏で見えにくくなったものがある。静的解析で明確だった過去と違い、今は「なぜそのコードがその設計なのか」を読む力が求められる場面が増えているのに、現場では「とにかく動くかどうか」を優先する流れが残っていた。
翔太の相棒は「Claude Code」と呼ぶ生成支援ツールだ。自然な日本語で指示でき、コードを一気に出す力は魅力的だが、そこには幻覚と呼ばれる間違いが混ざる危険がある。あるリリースでは、AIが生成した条件分岐が業務ルールを満たさず、製品が戻されてTTR(手戻り時間)が伸び、ROIに悪影響を与えた。責任の所在も曖昧になり、誰が最終判断を下すのかが不明確だった。
失敗が重なったことで、翔太はレビューの目的を見直し始めた。単なる構文チェックやテスト通過の確認だけでなく、ビジネス要件、設計思想、データ品質、ガバナンスの観点からコードが生む影響を読み解くことが必要だと気づいた。RAG(外部知識を参照して生成する仕組み)の文脈に沿ってレビューを再設計し、生成AIの提案は仮説として扱い、人間が意味と影響を付与する手順を導入した。
転機は教育だった。翔太は教育担当と協力し、レビューが「意味と影響を読み解く作業」へ変わるためのワークショップを開いた。失敗事例を共有し、幻覚リスクの見分け方、データガバナンスの基本、ビジネスルールの守り方を具体的に学んだ。最初は抵抗もあったが、現場の多くが自分の判断基準を持てるようになり、品質の本質に向き合う姿勢が広がった。
結末として、翔太は役割を再定義した。速さを支えるAIを受け入れながらも、レビューの中心を「コードの正確さ」から「コードがもたらす影響」へと移した。幻覚リスクや責任の所在を明確にし、教育と文化で補うことで、組織は次の挑戦に備えられる足場を作り始めた。これがAI時代に求められる、新しいコードレビューの第一歩だった。
■用語解説
- Claude Code:自然言語で指示してコードを生成するAIツールの例示名。
- 幻覚(幻覚リスク):AIが事実にない情報を自信ありげに出す現象。
- RAG:外部の情報を参照してAIの出力を補強する仕組み。
- TTR:手戻り時間。問題発生から修正完了までの時間。
- ROI:投資対効果。投入したコストに対する成果の割合。
- データガバナンス:データの管理ルールや責任の体系。
- Accuracy Rate:正確さを示す指標。
第2章:幻覚と責任のあいだで立ちすくむ
第2章:幻覚と責任のあいだで立ちすくむ - 本文
導入
プルリクの差分は小さく見えた。AIが生成した修正はテストを通り、静的解析も赤を出さない。だがリリース後、業務画面の表示順や権限チェックの微妙なずれが顧客データの扱い方針と衝突した。翔太はコードの行間に「意味のずれ」が潜んでいる現実を突きつけられた。
展開(失敗期)
AIは大量のコード例やドキュメントで学ぶが、学習データの偏りや欠落が幻覚を生む。例えばOpenAI API経由で取得した補完は、設計意図や社内ルールを知らない。静的解析は型や構文の誤りを拾うが、業務ルールや権限モデルの齟齬は見えない。社内ログやRAG(情報再帰検索)を遡ると、レビュー時間の短縮を重視し、人的レビューがルーチン化して薄くなっていた。結果、テストカバレッジが機能面で偏り、セキュリティと合規性の穴が残った。歴史的にはCOBOLやJavaで保守されてきたビジネスロジックが散在し、コンテキスト把握が難しいという構造的問題もある。
転換(解決期)
翔太は手順を変えた。RAGで関連仕様と過去のPRを自動で紐づけ、Supabaseに整理したメタデータを参照するワークフローを作り、AIの出力には必ず「発行理由」と「影響範囲」の注釈を付けさせた。プロンプトエンジニアリングでAIに社内ルールを反映させ、人間増強の観点で最終承認者のチェックリストを明確化した。レビューは単なるバグ検出から、意味と責任を検証するガバナンス活動へ転換した。法務やリーガルテックとも連携し、誰が最終責任を負うかを明文化したことで、曖昧さが減った。
結末
失敗は不可避だが同じ失敗は防げる。AIは速さをくれるが、意味を補完するのは組織の仕組みと教育だ。Next.js 15のような最新フレームワークやOpenAIの技術は道具であり、責任は人に残る。翔太と美咲の教訓は明快だ。テクノロジーへの依存を見直し、データ整備と文化改革を同時に進めることで、速さと品質の両立が現実のものになる。
■用語解説
- RAG:関連文書を検索してAIに参照させる仕組み。
- プロンプトエンジニアリング:AIへの指示文を工夫して望む出力を得る技術。
- 人間増強:AIで人の判断や作業を支える考え方。
- リーガルテック:法律領域の技術利用。
- Supabase:データベースや認証を提供するサービス。
- Next.js 15:フロントエンド開発用のフレームワーク(バージョン名)。
- OpenAI API / OpenAI:AIモデルにアクセスするためのAPIと提供組織。
- COBOL / Java:歴史的に業務システムで使われてきたプログラミング言語。
第3章:Claude Codeと意味を読み解く対話
第3章:Claude Codeと意味を読み解く対話 - 本文
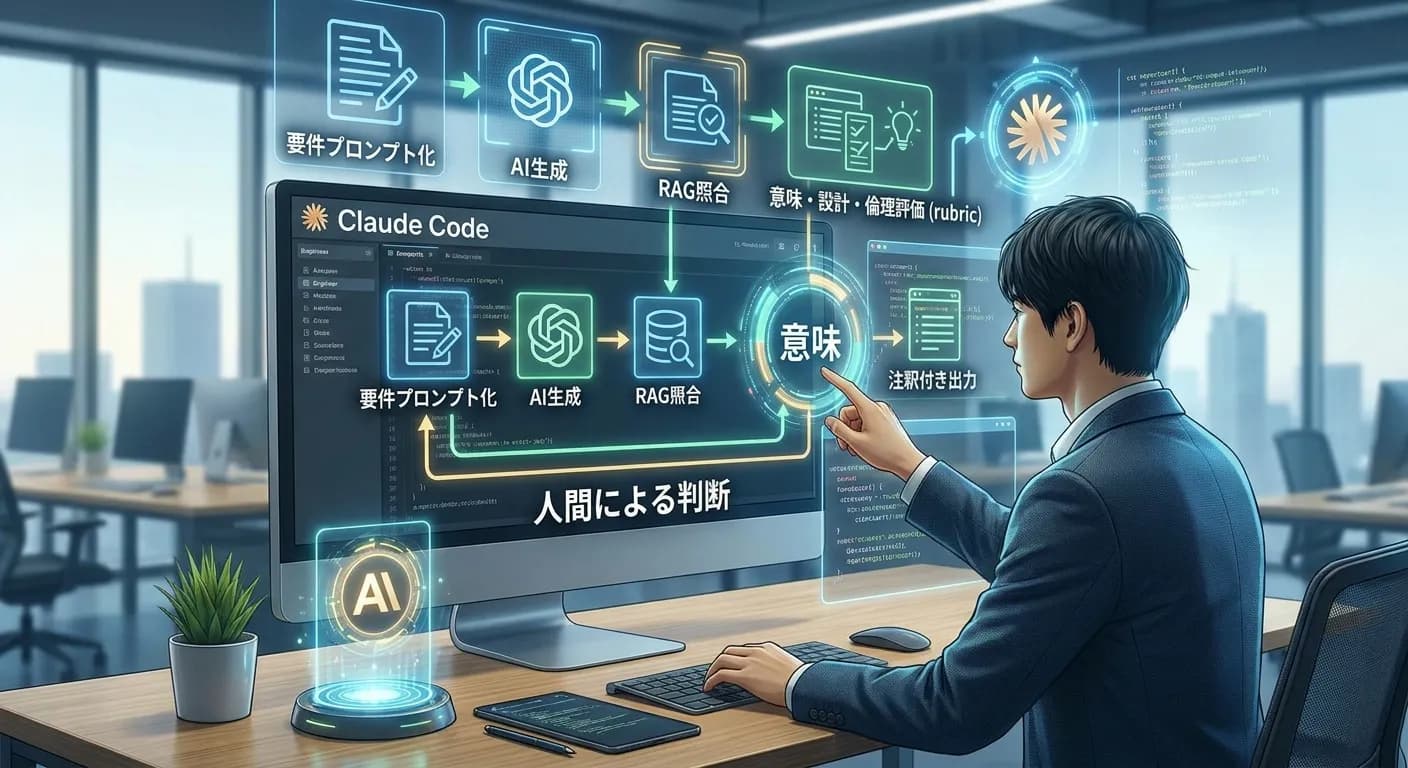
朝の静けさの中、翔太は行き詰まりを感じていた。AIが出す差分は正しいが、業務ルールや設計意図に合っていない。その壁を破ったのが、あるClaude Codeのセッションだった。講師の言葉は翔太の胸に響いた。「AIは構文・脆弱性を指摘する補助ツール。重要なのは、なぜこの実装がビジネス上適切なのか、設計思想に沿っているのか、倫理的にも問題はないかを人間が判断することだ」
その瞬間、翔太の頭に新しい地図が描かれた。HUMANとAIが協働するワークフロー、プロンプト設計の工夫、そして意味と影響を評価するrubric。彼は8×8の盤面になぞらえ、数手先を読むミニマックスの精神でコードレビューを組み立てた。最初の試行ではrubricが冗長で実務に合わず失敗した。だが指標を絞り、ビジネス適合性・設計整合性・倫理・セキュリティ・テストまでを定量化することで現場適用が進んだ。
新しいワークフローはこう動く。プロンプトで要件を明確化→Claude Codeが生成→RAGで事実照合→人間が意味付けしrubricで採点→注釈付き出力を残す。静的解析中心から、「意味と影響」を重視する評価軸への転換は、速度と品質の両立を現実に変えた。
定義ボックス
- RAG: 外部知識を参照して応答を補強する仕組み
- rubric: 評価指標の集合、定量・定性の基準を含む
- プロンプト設計: AIに与える指示文の工夫
- ミニマックス: 先を読む戦略の比喩
■用語解説
RAG: 引用と照合で誤情報を減らす手法。
rubric: 何をどう評価するかを書いたチェックリスト。
プロンプト設計: 期待する出力を得るための指示作り。
ミニマックス: 先読みで最善手を選ぶ考え方。
第4章:実践の設計—人間とAIの協調ワークフローを築く
第4章:実践の設計—人間とAIの協調ワークフローを築く - 本文
第4章:実践の設計—人間とAIの協調ワークフローを築く
翔太はチームを集め、まずプロンプト設計のワークショップを開いた。失敗から学んだ教訓は明確だ。AIは速いが意味と影響の判断は人の責任である。ワークショップでは、AIに任せる領域と人が介入する領域を紙に書き出し、役割を決めていった。ここから始まる実運用の手順を、現場で使える形に落とし込む。
実行手順(ステップバイステップ)
- ワークショップ準備:要件、設計方針、過去のミス事例(例:COBOL→Javaの検出率変化)を共有。成果物は「AI領域一覧」と「人間判断一覧」にする。
- プロンプトテンプレート作成:入力例、期待出力、失敗ケースをテンプレ化。テンプレはバージョン管理する。
- 自動検出ルール実装:構文・セキュリティスキャンはAI支援で自動化。検出はアラートとともにRAGデータで裏取り。
- 人間レビュー定義:ビジネス適合性、設計思想、倫理性をチェックするリストを用意。最終決定者を明確にする。
- 評価スキーム導入:「8×8盤面の重みづけ」を設定。コーナー=100点、隣=-50点、辺=10点、中央=0〜5点。AI出力を各マスの観点(安全、拡張性、透明性など)でスコア化し合計で判定。
- 初回応答運用:AI生成の初回は必ず人が検証。重大な不一致時はロールバック計画を起動。
- 学習ループ運用:レビュー結果をプロンプトと自動ルールに反映。月次で指標を見直す。
- 教育と文化変革:短期研修と事例共有を定期開催し、権限と責任の文化を育てる。
以下は実務で出てくる専門用語の定義箱。
定義:RAG(Retrieval-Augmented Generation)— 外部データでAI出力を裏付けする手法。
定義:ハルシネーション— AIが根拠なく誤情報を生成する現象。
定義:プロンプトエンジニアリング— AIに期待する出力を作る技術。
定義:グラウンディング— 出力の根拠をデータに結びつける作業。
結末は明快だ。翔太たちの現場は、AIの速さを活かしつつ、人間の判断で意味と責任を守る体制へと変わった。8×8の可視化は議論を簡単にし、教育が失敗を資産に変えた。速さと品質は両立する。
■用語解説
RAG:外部資料でAIの出力を検証する仕組み。
ハルシネーション:根拠のない誤出力のこと。
プロンプトエンジニアリング:AIへの命令文を設計する技術。
グラウンディング:出力の根拠を明示する作業。
Right to Disconnect:作業の切り離しや休息を保障する権利(組織運用上の配慮)。
第5章:現場で測る成果—70%の時間削減と検出力の向上
第5章:現場で測る成果—70%の時間削減と検出力の向上 - 本文
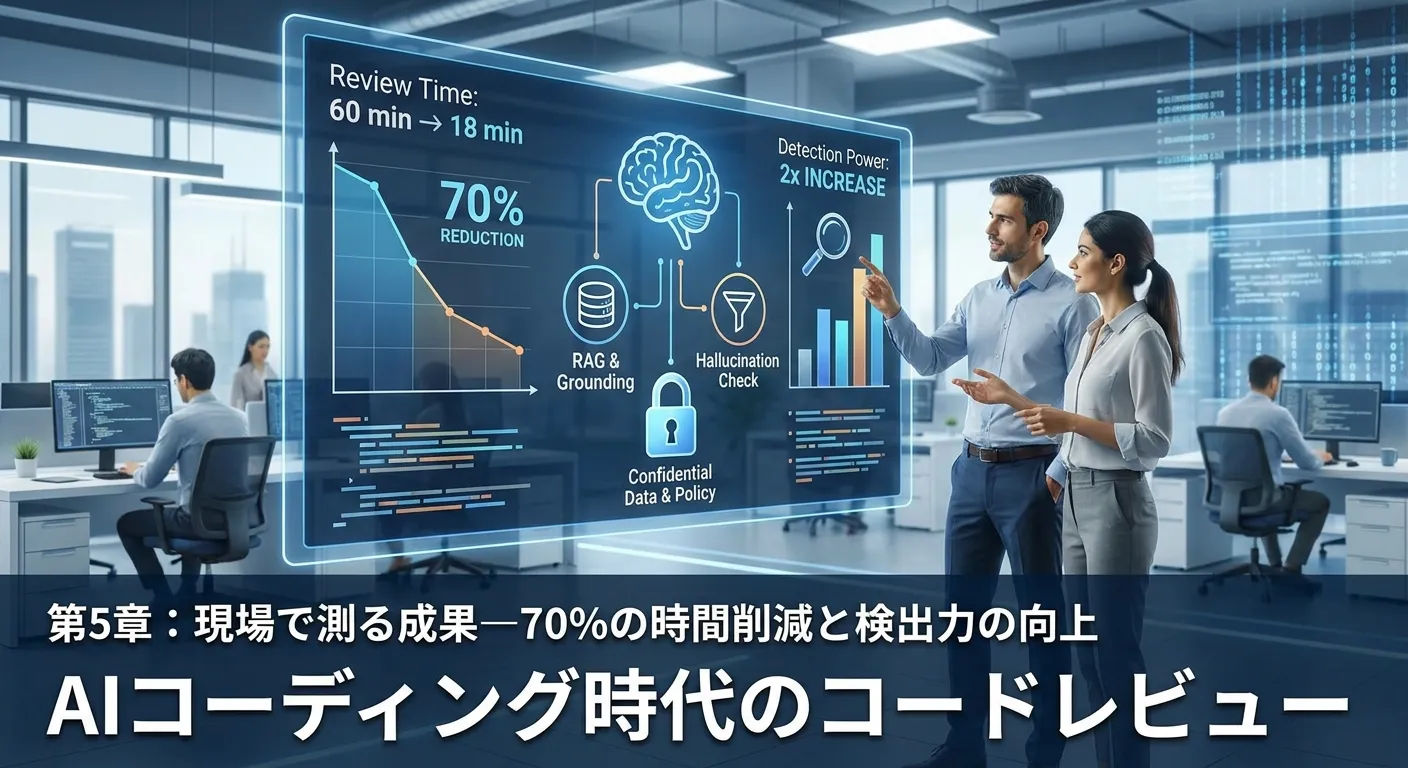
数か月のパイロットが終わり、翔太のチームには数字が残った。AI生成コードを組み込んだレビューで、平均レビュー時間は約70%削減された(例:1件あたり60分→約18分)。その余剰時間で設計やセキュリティ監査に集中でき、意思決定の質が上がった。ビジネスロジックの誤り検出率は従来の2倍に跳ね上がり、重大な仕様漏れを早期に防げるようになった。
失敗の壁も痛感した。AIのハルシネーション(根拠なしの回答)が混入し、古いCOBOL資産をJava化する移行案件では誤った変換案が出た。初期は出力の根拠が追えず、機密データの扱いでポリシー違反が起きかけた。対策としてRAGを使ったグラウンディング(外部知識の参照)と、出力トレースのログ化、自動検出ルールの強化を導入。AI-OCRで取込む伝票やMES/ERP連携、RPAやエッジAI、IoTセンサーからのデータを分離し、機密と非機密を運用で明確化した。
転換のきっかけは「人が最後まで説明責任を持つ」運用ルールの徹底だ。モデルの提示をそのまま受け取らず、検証ポイントを定めたチェックリストで運用。教育も数値化し、時系列でスキルが30%向上、ガバナンス遵守率は90%超を維持する仕組みを確立した。
結末は明快だ。工具としてのAIは速さを生むが、品質は人と組織文化が担保する。翔太は胸の内で語っている。技術は道具であり、最終的な判断は人にある。幻覚を見抜く眼と相互学習の謙虚さが、真のコード品質をつくり出す。
■用語解説
- ハルシネーション: AIが根拠なく誤った情報を出す現象
- RAG: 外部データを参照してAI出力を補強する仕組み
- グラウンディング: 出力を外部情報で裏付けること
- COBOL: 古い業務系言語。レガシー資産に多い
- MES/ERP: 製造や業務を管理する基幹システム
- AI-OCR: 文字画像をAIで読み取る技術
- RPA: 定型作業を自動化するソフトロボット
- エッジAI / IoTセンサー: 現場でデータ処理する小型AIとセンサー群
第6章:読者へ届けたいメッセージ
第6章:読者へ届けたいメッセージ - 本文
翔太は振り返る。最初は生成AIに任せたコードが速くても、思わぬ「幻覚(ハルシネーション)」や誤った外部参照で痛い目を見た。レビュー時間を60→18分に短縮できた成功と、誤出力での一時的な障害という失敗を糧に、彼らは仕組みを作り直した。決定打はRAGと出力追跡、そして人が最終判断を下す運用だった。
重要なポイント:
- 高次判断の価値を育てる教育と実践
RAGや追跡で根拠を明示し透明性を確保- 指標で成果を測る(
70%時間削減、2倍検出力)と幻覚監視を並走
具体的な次の一歩(実行チェックリスト):
- 導入パイロット:対象モジュールでAI支援レビューを実施
- 指標設定:レビュー時間、検出率、幻覚発生率を測定
- 運用ルール:`review_policy.md`を作成し最終承認者を明示
- 教育計画:ブレンデッド型の学習で技能と批判的思考を育成
- ガバナンス:データ扱いと責任所在をドキュメント化
翔太の結びは明快だ。AIがもたらす速さを活かしつつ、意味と影響を読み解く力を伸ばすことで、コードと人の両方が成長する「創造的な価値」が生まれる。組織はこの変化を止めず、学び続けることを選んだ。
■用語解説
- RAG:外部データでAI出力を裏付ける仕組み(Retrieval-Augmented Generation)
- ハルシネーション:AIが根拠なく誤情報を生成する現象
- グラウンディング:出力と現実の情報を結びつけること
- ブレンデッド型の学習:オンラインと対面を組み合わせた学習法
関連キーワード
著者について
鈴木信弘(SNAMO)
鈴木信弘(SNAMO)- 静岡県焼津市を拠点に活動する総経験19年のフルスタックエンジニア。AI時代の次世代検索最適化技術「レリバンスエンジニアリング」の先駆的実装者として、GEO(Generative Engine Optimization)最適化システムを開発。2024年12月からSNAMO Portfolioの開発を開始し、特に2025年6月〜9月にGEO技術を集中実装。12,000文字級AI記事自動生成システム、ベクトル検索、Fragment ID最適化を実現。製造業での7年間の社内SE経験を通じて、業務効率75%改善、検品作業完全デジタル化など、現場の課題を最新技術で解決する実装力を発揮。富山大学工学部卒、基本情報技術者保有。
プロフィールを見る